
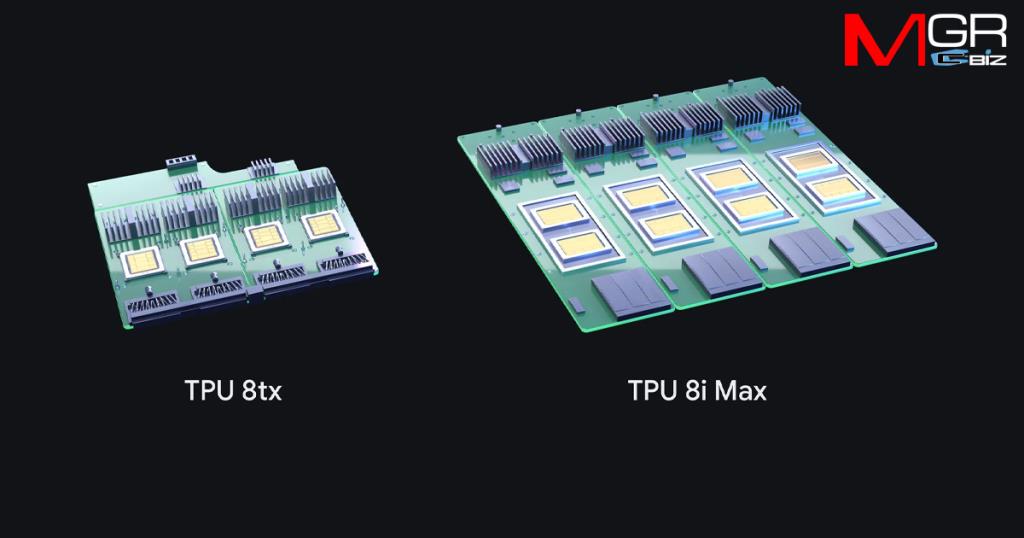
Google ประกาศขยายกลุ่มผลิตภัณฑ์ชิปประมวลผล TPU (Tensor Processing Unit) ในเจเนอเรชันที่ 8 ด้วยการเปิดตัวระบบประมวลผลเพิ่มเติมอีก 2 รุ่น ได้แก่ TPU 8i Max และ TPU 8tx ออกแบบมาประมวลผล AI ที่ต้องการความปลอดภัยและการประมวลผลข้อมูลที่มีบริบทซับซ้อน
การเคลื่อนไหวครั้งนี้เกิดขึ้นท่ามกลางการเติบโตอย่างก้าวกระโดดของธุรกิจ TPU ซึ่งปัจจุบันมีลูกค้านำไปใช้งานแล้วเกือบ 100 ราย ครอบคลุมตั้งแต่สถาบันวิจัย AI ชั้นนำ บริษัทด้านการซื้อขายหลักทรัพย์ ธุรกิจค้าปลีก ไปจนถึงสถาบันการศึกษา
นอกจากการนำมาใช้งานภายในของ Google ทั้งการฝึกฝนและให้บริการโมเดล Gemini การรองรับระบบ Agent ตลอดจนบริการคลาวด์แล้ว Google ยังเปิดให้ลูกค้านำระบบประมวลผลดังกล่าวไปติดตั้งใช้งานได้โดยตรงภายในศูนย์ข้อมูล (Data Center) ของตนเอง เพื่อเพิ่มความยืดหยุ่นในการบริหารจัดการโครงสร้างพื้นฐาน
ทั้งนี้ ชิปรุ่นใหม่ทั้งสองโมเดลพัฒนาต่อยอดมาจากสถาปัตยกรรมพื้นฐานของ TPU 8t และ TPU 8i ที่เปิดตัวไปเมื่อเดือนเมษายนที่ผ่านมา ซึ่งมีประสิทธิภาพในการเทรนโมเดลสูงขึ้นถึง 2.7 เท่า และความคุ้มค่าต่อราคาในการประมวลผลดีขึ้น 80% เมื่อเทียบกับรุ่นก่อนหน้า
การเสริมทัพด้วย TPU 8i Max และ TPU 8tx มีเป้าหมายเพื่อแก้โจทย์ท้าทายสำคัญ 2 ด้าน ได้แก่ การปกป้องข้อมูลระดับฮาร์ดแวร์ และการรองรับบริบทการประมวลผลขนาดใหญ่ระดับล้านโทเค็น ที่มีความจำเป็นมากขึ้นในปัจจุบัน
นายอามิน วาห์ดัต (Amin Vahdat) ประธานเจ้าหน้าที่ฝ่ายเทคโนโลยีและรองประธานอาวุโสฝ่าย AI และโครงสร้างพื้นฐานของ Google กล่าวว่า ในช่วงเวลาที่การประมวลผลกำลังเปลี่ยนผ่านจากการรองรับการทำงานของมนุษย์ไปสู่ยุคของ Agent ภาคธุรกิจจำเป็นต้องมีชิปประมวลผลความเร็วสูงที่สามารถรองรับการให้เหตุผลบนบริบทข้อมูลขนาดใหญ่
ขณะเดียวกัน กลุ่มอุตสาหกรรมที่มีข้อกำหนดด้านกฎระเบียบสูงก็ต้องการเทคโนโลยีการเข้ารหัสเฉพาะทาง การเปิดตัวระบบใหม่นี้จึงพัฒนาขึ้นเพื่อตอบโจทย์ดังกล่าว ควบคู่กับการรองรับเฟรมเวิร์ก PyTorch เพื่อช่วยให้นักพัฒนาเข้าถึงฮาร์ดแวร์ที่ออกแบบเฉพาะและมีโครงสร้างแบบโมดูลาร์ได้สะดวกยิ่งขึ้น
4 ระบบประมวลผล TPU เจนฯ 8
TPU 8tx สำหรับงานความปลอดภัยสูงและการเทรนเฉพาะทาง พัฒนาบนสถาปัตยกรรมเดียวกับรุ่น 8t ทำงานร่วมกับหน่วยประมวลผลกลาง (CPU) จาก AMD ที่ปรับแต่งเป็นพิเศษ โดยผสานระบบรักษาความปลอดภัยในระดับฮาร์ดแวร์เพื่อแยกและปกป้องข้อมูลสำคัญรวมถึงค่าน้ำหนักของโมเดลแม้ในระหว่างประมวลผล พร้อมเชื่อมต่อด้วยเครือข่าย Boardfly ที่มีความหน่วงต่ำ (Low Latency) ช่วยลดความหน่วงลง 2 เท่าเมื่อเทียบกับรุ่น 8t เหมาะสำหรับองค์กรภาครัฐและธุรกิจที่อยู่ภายใต้การกำกับดูแลเข้มงวด
TPU 8i Max สำหรับงานประมวลผลบริบทขนาดใหญ่ ออกแบบมาเพื่อแก้ปัญหาคอขวดด้านแบนด์วิดท์หน่วยความจำเมื่อต้องรัน Agent จำนวนมากพร้อมกัน โดยให้ประสิทธิภาพการประมวลผล หน่วยความจำ SRAM และแบนด์วิดท์ HBM เพิ่มขึ้นเป็น 2 เท่าเมื่อเทียบกับรุ่น 8i อีกทั้งยังรองรับความหนาแน่นในการติดตั้งชิปเพิ่มขึ้น 2 เท่าในพื้นที่ตู้แร็กเดิม ช่วยประหยัดพื้นที่และพลังงานในดาต้าเซ็นเตอร์
TPU 8t สำหรับงานเทรนโมเดลพื้นฐานขนาดใหญ่ มุ่งเน้นการเพิ่มปริมาณผลลัพธ์จากการประมวลผลที่เป็นประโยชน์ (Goodput) ให้ได้สูงสุดต่อพลังงานที่ใช้หนึ่งวัตต์
TPU 8i สำหรับงานประมวลผลเพื่อการให้เหตุผล (Inference) หน่วยประมวลผลความหน่วงต่ำที่ออกแบบมาเพื่อลดข้อจำกัดด้านหน่วยความจำและลดความล่าช้าในการสื่อสารระหว่างชิปลงได้สูงสุดถึงครึ่งหนึ่ง