
นูทานิกซ์ (Nutanix) เผยแนวโน้มการใช้งานโมเดลปัญญาประดิษฐ์ที่มีขนาดประมวลผลย่อมลงมาหรือ Small AI และ Local AI กำลังมาแรงในตลาดไทย หลังองค์กรต้องการควบคุมต้นทุนการทำงานของปัญญาประดิษฐ์ (AI) สุดภูมิใจทดลองควบคุมต้นทุน AI ด้วยสูตร 80 - 20 รัน Open Weight Models ภายในองค์กร จนสามารถลดค่าใช้จ่ายได้จริง 50 เปอร์เซ็นต์ เพิ่มความมั่นใจเดินหน้าสู่ยุค Hybrid AI เต็มรูปแบบ
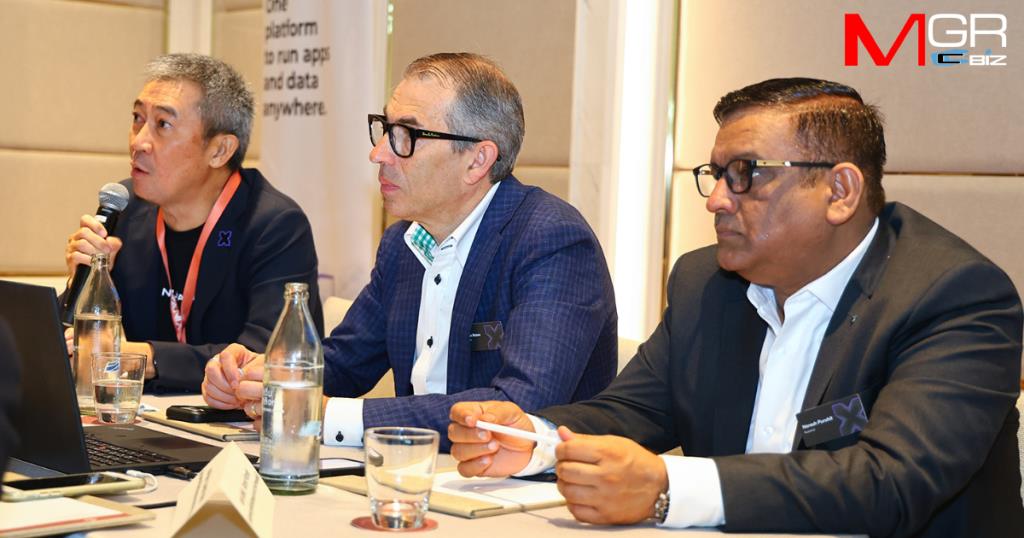
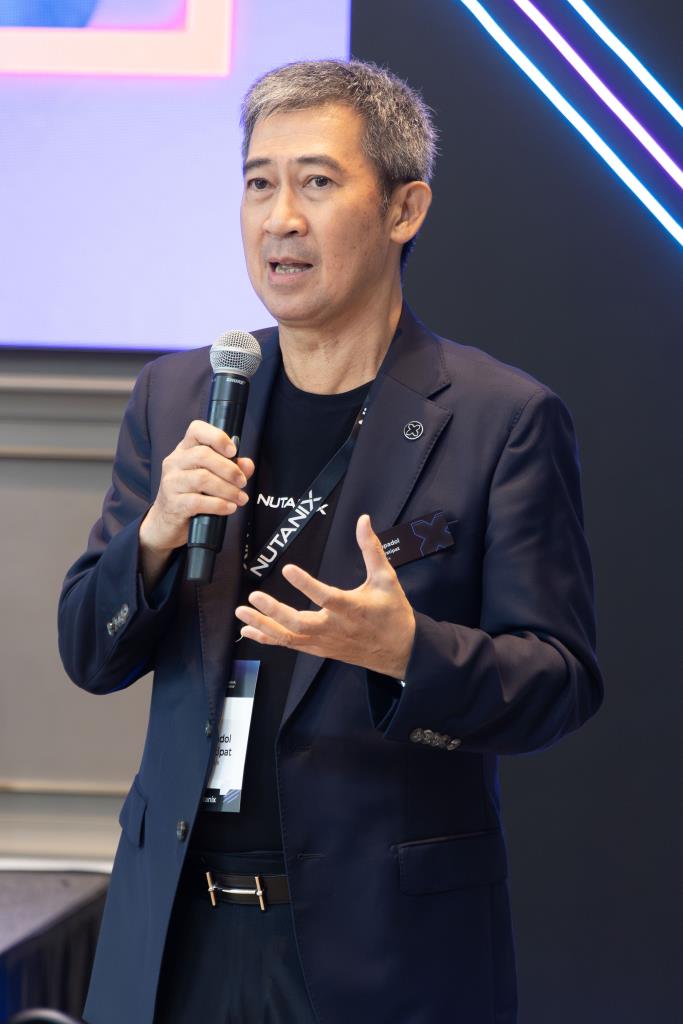
นายนพดล ปัญญาธิปัตย์ ผู้จัดการประจำประเทศไทย นูทานิคซ์ กล่าวว่าตลาด Small AI และ Local AI ในประเทศไทยและภูมิภาคกำลังเป็นแนวโน้มที่เติบโตขึ้นอย่างต่อเนื่อง และกลายเป็นประเด็นพูดคุยสำคัญในทุกการประชุมขององค์กรยุคปัจจุบัน โดยองค์กรในไทยหลายแห่ง เช่น ฝั่ง Retail, Manufacturing, Financial) เริ่มมองหาโซลูชัน Local AI แนวโน้มสำคัญของอุตสาหกรรมในปัจจุบันจึงคือการปรับตัวสู่รูปแบบ Local AI และ Hybrid AI ในการปรับใช้ Small AI ภายในองค์กร
"ตัวอย่างเช่น ผู้ให้บริการแอปพลิเคชันกระเป๋าเงินดิจิทัล (Digital Wallet) ในไทย ที่เพิ่มระบบแชทซัปพอร์ต (Chat Support) ให้แก่ผู้ใช้งานทั่วประเทศ แต่ต้องเผชิญปัญหาไม่สามารถควบคุมค่าใช้จ่ายเบื้องหลังบน Public Cloud ที่คิดตามปริมาณการใช้งานจริงได้ จึงเปลี่ยนมามองการลงทุนใน Local AI / Small AI เพื่อประมวลผลในประเทศแทน"
Small AI และ Open Weight Models นั้นแตกต่างจาก Frontier Models เพราะ Frontier Models คือ AI ระดับท็อปบน Public Cloud ที่คิดค่าบริการตามปริมาณการใช้งานจริง หรือ Per-token / CPM เช่น 1 Trillion Tokens ซึ่งยากต่อการควบคุมงบประมาณ สำหรับ Open Weight Models (Small AI / Open Source AI) คือโมเดล AI ที่เปิดให้นำน้ำหนักโมเดล (Weights) มาติดตั้ง ประมวลผล และรันอยู่บนเซิร์ฟเวอร์หรือ Data Center ขององค์กรได้เอง
สำหรับ Small AI มักมีขนาดโครงสร้างประมาณ 10-20 พันล้านพารามิเตอร์ ซึ่งมีความสามารถสูงพอที่จะประมวลผลบนหน่วยประมวลผลระดับ CPU รุ่นใหม่ๆ หรือบน GPU ได้อย่างมีประสิทธิภาพ
***เปิดเคส Nutanix ลองจริง ประหยัดจริง
นายจอร์แดน ไรส์ รองประธานฝ่ายการตลาดประจำภูมิภาคเอเชียแปซิฟิกและญี่ปุ่น นูทานิคซ์ เผยว่าในปีงบประมาณล่าสุด ที่สิ้นสุดเดือนกุมภาพันธ์/กรกฎาคม Nutanix สามารถเพิ่มลูกค้ารายใหม่ทั่วโลกมากกว่า 3,000 ราย ทำให้มีฐานลูกค้ารวมมากกว่า 32,000 ราย ผ่านการขยายระบบนิเวศพันธมิตร และขยายความร่วมมือกับผู้ให้บริการจัดเก็บข้อมูลชั้นนำอย่าง NetApp, Pure Storage ผู้ให้บริการ Public Cloud ทั้ง AWS, Azure, Google Cloud รวมถึงพันธมิตรฝั่ง AI (Nvidia, AMD, Hugging Face ทำให้บริษัทรักษาคะแนน NPS ได้สูงกว่า 90+ คะแนน ติดต่อกันยาวนานถึง 11 ปี ซึ่งเป็นหนึ่งในสถิติที่สูงที่สุดในอุตสาหกรรม
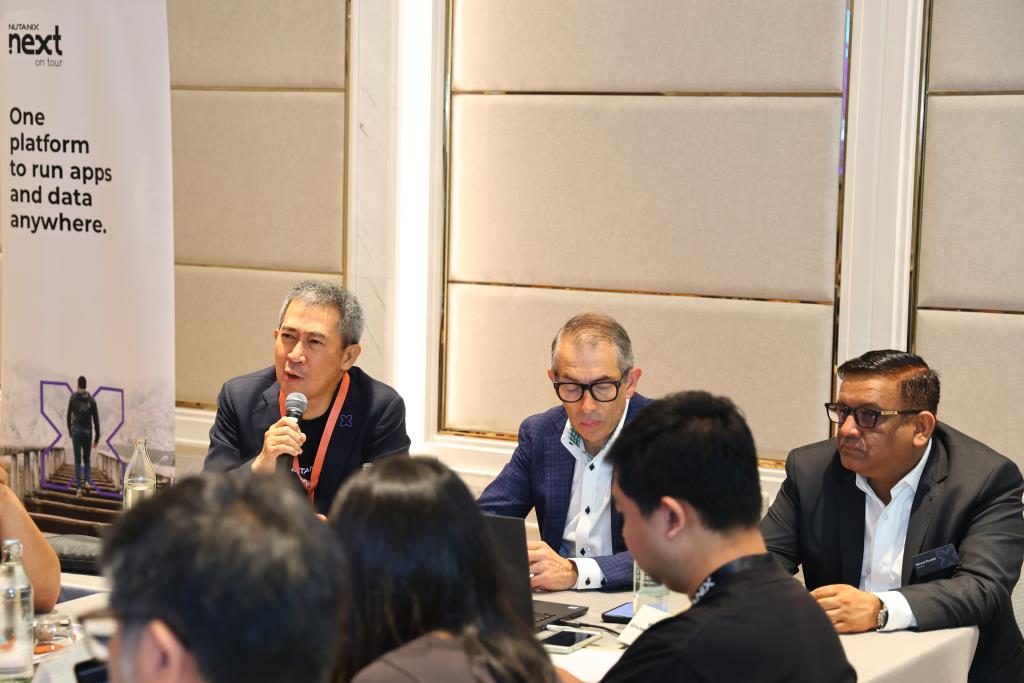
อย่างไรก็ตาม Nutanix เห็นปัญหาความซับซ้อนและไซโลในอุตสาหกรรมไอที เนื่องจากองค์กรทั่วโลกกำลังเผชิญกับค่าไลเซนส์ซอฟต์แวร์ Virtualization ที่สูงขึ้น, ปัญหา Supply Chain ขาดแคลนฮาร์ดแวร์ รวมถึงประเด็นความปลอดภัยและอธิปไตยทางข้อมูลจากการใช้ AI เมื่อมองลึกลงไปในช่วง 20 ปีที่ผ่านมา เทคโนโลยีทั้ง Virtualization, Cloud, Kubernetes และ AI ในแต่ละยุคได้สร้างไซโลการบริหารจัดการที่แยกออกจากกัน รวมถึงไซโลการประมวลผลระหว่าง GPU กับ CPU โซลูชันของ Nutanix จึงนำเสนอแนวคิด One Platform, One Management Experience เพื่อให้องค์กรสามารถบริหารจัดการทุกแอปพลิเคชันและทุกโครงสร้างพื้นฐานข้ามทุก Silo ได้อย่างไร้รอยต่อ
ความสนุกคือ ทีมวิศวกรซอฟต์แวร์ของ Nutanix กว่า 2,500 คน มีการใช้งาน AI ในกระบวนการพัฒนาซอฟต์แวร์ (SDLC) สูงถึง 1 ล้านล้าน Tokens ต่อเดือน เมื่อผู้ให้บริการปรับระบบคิดราคาเป็น Per-token ส่งผลให้ค่าใช้จ่าย AI พุ่งสูงขึ้นถึง 350%
Nutanix จึงลงทุน 20 ล้านดอลลาร์สหรัฐ ในการจัดซื้อเซิร์ฟเวอร์ GPU (ทั้ง Nvidia และ AMD) มาติดตั้งใน Data Center ของตัวเองเพื่อรองรับการรัน Open Weight Models แม้ช่วงแรก Nutanix ตั้งใจจะเปลี่ยนมาใช้ Open Weight 100% แต่ผลการทดลองพบว่า Open Weight ไม่สามารถแทนที่ Frontier Models ได้ทั้งหมด จึงสรุปสัดส่วนการใช้งานที่เหมาะสมที่สุด คือ 80% รันบน Open Weight Models (Small AI) สำหรับงานทั่วไปในกระบวนการ SDLC เช่น การเขียนโค้ด (Coding), การทดสอบ (QA Testing), การออกแบบหน้าจอ (Front-end Design) และงานค้นหาเอกสาร ขณะที่อีก 20% รันบน Frontier Models สำหรับงานที่ต้องการความเชี่ยวชาญ/ความฉลาดขั้นสูง หรือใช้สำหรับทดสอบเปรียบเทียบประสิทธิภาพ (Benchmark)
สำหรับการเช่าใช้ GPU Server หรือรันบนเครื่องของตนเองจะคิดราคาแบบเหมาจ่ายคงที่รายเดือน ต่างจากการยิง API หา Frontier Model ที่คิดราคาตาม Token ทำให้องค์กรคำนวณและคาดการณ์งบประมาณได้ชัดเจน โดยหากองค์กรเผชิญปัญหาฮาร์ดแวร์ GPU ขาดแคลนหรือราคาแพง ก็สามารถเลือกนำโมเดล Small AI ไปรันบน Public Cloud ก่อนได้
ที่สุดแล้ว การรัน Small AI ภายในศูนย์ข้อมูลขององค์กรเองจะช่วยแก้ปัญหาเรื่อง Data Sovereignty และป้องกันความลับขององค์กรรั่วไหลออกสู่ภายนอก โดย Nutanix แนะว่าองค์กรสามารถนำเทคนิค RAG (Retrieval-Augmented Generation) และ Enterprise Knowledge Base Search มาใช้ร่วมกับ Small AI โดยให้โมเดลดึงข้อมูลเอกสารภายในองค์กรมาประมวลผลคำตอบได้ทันที ทำให้ได้ผลลัพธ์แม่นยำโดยไม่ต้องส่งข้อมูลสำคัญออกไปนอกบริษัท
Nutanix ทิ้งท้ายถึงการนำ Small AI มาใช้งานให้เกิดผลจริงในเชิงธุรกิจ ว่าไม่จำเป็นต้องใช้สัดส่วน 80/20 เท่ากันทุกองค์กร เนื่องจากสัดส่วนการใช้งานขึ้นอยู่กับโจทย์ธุรกิจและลักษณะงาน เช่น งานสรุปและค้นหาเอกสารองค์กร สามารถใช้ Small AI ประมวลผลได้ถึง 100% และการเปลี่ยนผ่านจากช่วงทดลอง (Pilot) ไปสู่การใช้งานจริง (Production) องค์กรต้องเริ่มจากการทำ ROI Analysis ร่วมกัน เพื่อประเมินต้นทุนฮาร์ดแวร์ ซอฟต์แวร์ และการดำเนินงาน ช่วยให้องค์กรทราบจุดคุ้มทุนและคาดการณ์ต้นทุนได้อย่างแม่นยำ.