
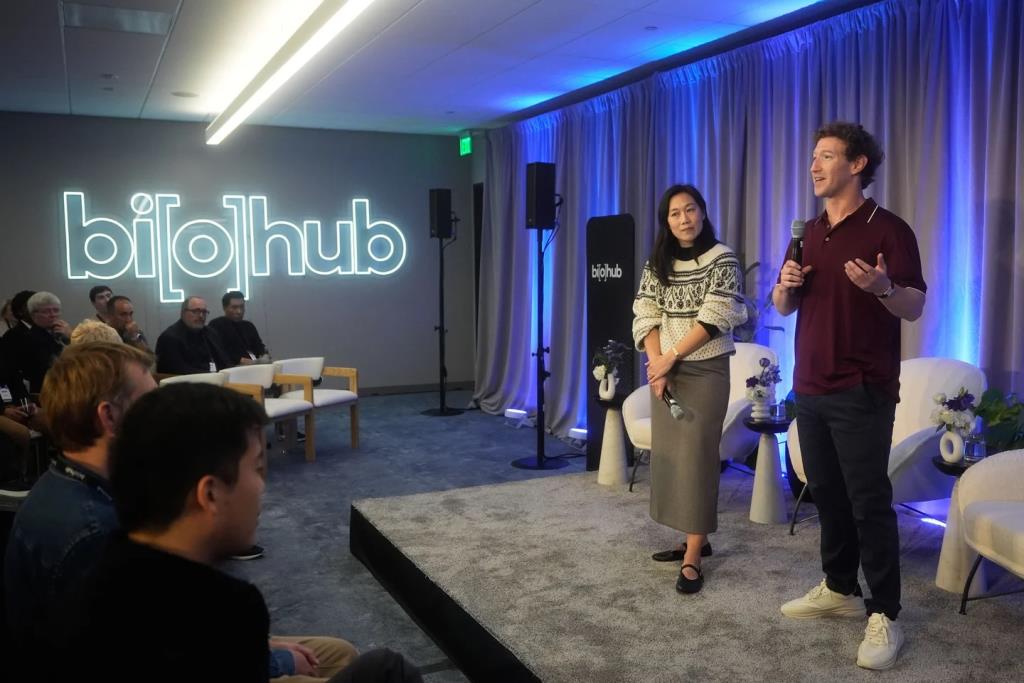
รัฐบาลสหรัฐฯ และบรรดาบริษัทยักษ์ใหญ่ด้านเทคโนโลยีอย่าง เมตา แพลตฟอร์มส์ (Meta Platforms) และ อัลฟาเบต (Alphabet) บริษัทแม่ของกูเกิล ได้เข้าร่วมกับไบโอฮับ (Biohub) ซึ่งเป็นองค์กรไม่แสวงหากำไร เพื่อสร้างชุดข้อมูลแบบเปิด (Open Datasets) สำหรับฝึกฝนโมเดลปัญญาประดิษฐ์ (AI) ในการวิจัยด้านชีววิทยา ส่งผลให้ยอดลงทุนรวมในความพยายามครั้งนี้พุ่งสูงถึง 1.8 พันล้านดอลลาร์ จากการแถลงในวันพุธโดย Biohub
เมตา (Meta), กูเกิล ดีพมายด์ (Google DeepMind) และบริษัทสตาร์ตอัปด้านการค้นคว้ายา ไอโซมอร์ฟิก แล็บส์ (Isomorphic Labs) ร่วมกันลงทุนเป็นมูลค่า 300 ล้านดอลลาร์ ด้านกระทรวงพลังงานสหรัฐฯ จะลงทุนมากกว่า 500 ล้านดอลลาร์ เป็นระยะเวลา 5 ปี ในด้านการวัดผลทางห้องปฏิบัติการ การสร้างแบบจำลอง และการคำนวณ ขณะที่สถาบันสุขภาพแห่งชาติสหรัฐฯ จะทำหน้าที่ประสานงานชุดข้อมูลและคลังข้อมูลที่สร้างขึ้นจากเงินทุนสนับสนุนของรัฐบาลกลางที่มีมูลค่ามากกว่า 500 ล้านดอลลาร์ ซึ่งทาง Biohub จะนำมาจัดระเบียบและทำให้เป็นมาตรฐานสำหรับการฝึก AI ต่อไป
การทุ่มงบประมาณเหล่านี้เกิดขึ้นต่อเนื่องจากที่ Biohub ซึ่งเป็นกิจการเพื่อการกุศลของ มาร์ก ซักเคอร์เบิร์ก ซีอีโอของ Meta และภรรยา ดร. พริสซิลลา ชาน ได้ลงทุนไปแล้ว 500 ล้านดอลลาร์ในโครงการนี้เมื่อเดือนเมษายนที่ผ่านมา
เงินลงทุนดังกล่าวจะนำไปสนับสนุน "โครงการชีววิทยาเสมือนจริง" (Virtual Biology Initiative) ซึ่งมีเป้าหมายเพื่อวัดผลว่าเซลล์ตอบสนองต่อการเปลี่ยนแปลงในสภาพแวดล้อมที่หลากหลายมากกว่าที่นักวิทยาศาสตร์เคยศึกษามาในอดีตอย่างไร พร้อมทั้งนำข้อมูลเหล่านั้นมาสร้างโมเดลพยากรณ์ที่สามารถช่วยร่นระยะเวลาในการพัฒนายาซึ่งปกติแล้วต้องใช้เวลานานหลายปี
"จนถึงตอนนี้ ชีววิทยาเป็นเสมือนวิทยาศาสตร์ที่ขับเคลื่อนด้วยการค้นพบที่ชาญฉลาดเพียงอย่างเดียว" ชานกล่าวในการให้สัมภาษณ์ "เรายึดมั่นมาตลอดว่าสิ่งนี้คือทรัพยากรของชุมชน ไม่ใช่สำหรับกลุ่มใดกลุ่มหนึ่ง เพื่อให้มันสามารถต่อยอดพัฒนาด้วยตัวเองได้ตามกาลเวลา"
อเล็กซ์ ไรฟส์ หัวหน้าฝ่ายวิทยาศาสตร์ของ Biohub ระบุว่า ชุดข้อมูลเหล่านี้จะถูกเปิดเผยต่อสาธารณชนในท้ายที่สุด แต่บริษัทที่ร่วมลงทุนจะได้รับสิทธิ์ในการเข้าถึงก่อน
"สำหรับผู้สนับสนุนทุนที่เป็นภาคธุรกิจ เราจะมีช่วงเวลาจำกัดสิทธิ์ ซึ่งเป็นช่วงเวลาที่กลุ่มบริษัทเหล่านั้นสามารถทำงานกับข้อมูลก่อนได้ หลังจากนั้นข้อมูลดังกล่าวจึงจะเปิดให้ใช้งานเป็นทรัพยากรทางวิทยาศาสตร์สาธารณะ" ไรฟส์กล่าว
การจัดสรรรูปแบบนี้คือวิธีที่ Biohub ดึงดูดเงินลงทุนภาคเอกชนเข้ามาสู่โครงการที่พวกเขาอธิบายว่าเป็นวิทยาศาสตร์แบบเปิด (Open Science) ไรฟส์กล่าวเพิ่มเติมว่า งานที่ได้รับทุนสนับสนุนจากรัฐบาลซึ่งดำเนินการควบคู่กันไปจะไม่มีข้อจำกัดดังกล่าว และ Biohub มีแผนที่จะทาบทามบริษัทเภสัชกรรมรวมถึงองค์กรการกุศลอื่นๆ เป็นลำดับถัดไป
ไรฟส์ระบุว่า ชุดข้อมูลเซลล์ในปัจจุบันมีจำนวนราวหลายร้อยล้านเซลล์ ในขณะที่โมเดลพยากรณ์ที่แม่นยำจะต้องใช้ข้อมูลระดับหลายพันล้านและอาจถึงขั้นหลายล้านล้านเซลล์ เป้าหมายของ Biohub คือการถมช่องว่างตรงนี้ให้เต็ม
"เราจำเป็นต้องจับภาษาราชการแห่งชีววิทยา จับภาษาของเซลล์ให้ได้ และสิ่งนั้นยังไม่มีอยู่จริงในปัจจุบัน" เขากล่าว
ข้อมูลดังกล่าวจะมาจากเทคนิคต่างๆ ซึ่งรวมถึง ทรานสคริปโตมิกส์เชิงพื้นที่ (Spatial transcriptomics) ที่ทำหน้าที่แมปการทำงานของโมเลกุลภายในเนื้อเยื่อที่สมบูรณ์ และการคัดกรองที่บันทึกการตอบสนองของเซลล์ต่อการเปลี่ยนแปลงของสิ่งแวดล้อม โดยข้อมูลส่วนใหญ่ไม่เคยถูกจัดทำขึ้นในลักษณะที่มีการประสานงานกันมาก่อน
ไรฟส์กล่าวว่า งานนี้ปกติแล้วต้องใช้เวลาหลายทศวรรษ แต่บรรดาพันธมิตรตั้งเป้าที่จะย่นระยะเวลาให้เหลือเพียง 5 ปี โดยชุดข้อมูลแรกน่าจะพร้อมใช้งานได้ในเวลาประมาณ 1 ปี และเขาคาดหวังว่าจะได้เห็นโมเดลพยากรณ์ที่แม่นยำภายใน 5 ปี
ห้องปฏิบัติการ AI อื่นๆ ก็กำลังดำเนินโครงการที่คล้ายคลึงกันเช่นกัน โดย Anthropic ได้ทุ่มงบประมาณด้านชีววิทยาเพิ่มขึ้นเป็นสองเท่าด้วยการสร้างห้องปฏิบัติการเปียก (Wet lab) ในขณะที่ OpenAI ได้ริเริ่มโครงการให้ทุนมูลค่ากว่า 125 ล้านดอลลาร์ เพื่อสนับสนุนชุดข้อมูลทางชีววิทยาและการแพทย์สำหรับการวิจัย AI
ที่มา รอยเตอร์